SIP + Hermes: un asistente de IA en casa con las reglas puestas por mí
SIP es mi Sistema de Inteligencia Personal, una especie de «segundo cerebro»: un asistente de IA que trabaja con mis documentos, corre en dos ordenadores de casa y no envía ningún dato personal a la nube. Hermes es el agente sobre el que está construido. Lo que lo hace seguro no es que el modelo se porte bien. Es que el sistema no le deja portarse mal.
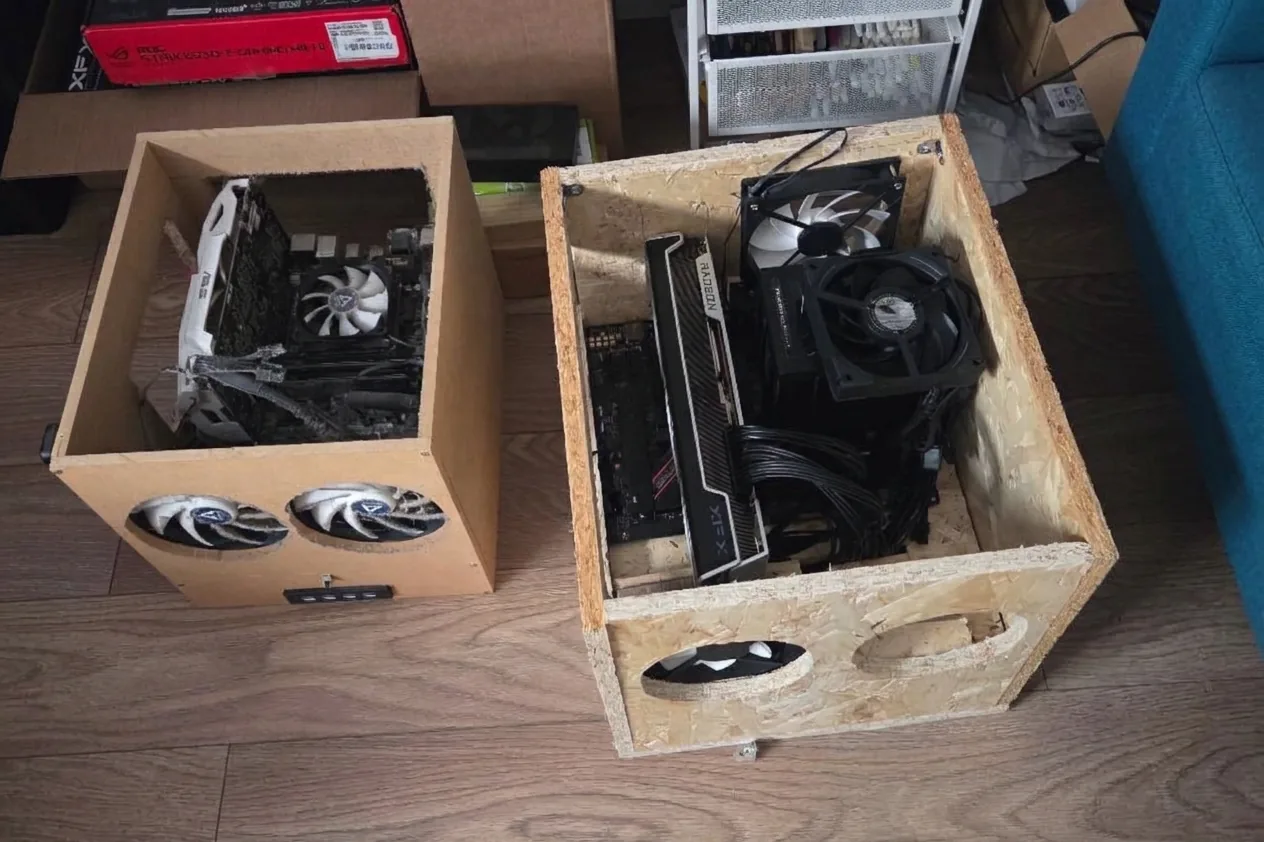
Los dos equipos, en las cajas que les hice: el servidor en MDF, a la izquierda, y el ordenador con la gráfica de 24 GB en OSB. Foto girada; parte del fondo, reconstruida con IA.
| Año | 2026 (diseño desde septiembre; en uso diario desde noviembre) |
| Estado | Funcionando en casa. Repositorio público para replicarlo |
| Equipos | Un servidor siempre encendido y un ordenador con tarjeta gráfica de 24 GB |
| Base | Hermes Agent (Nous Research), modelos abiertos ejecutados en local |
| Repositorio | github.com/apmysoft/sip-hermes |
El reto
Mi disco de casa tiene 4,4 TB y casi medio millón de archivos: facturas, contratos, notas, fotos, planos. Años de todo mezclado. Sé que lo que busco está ahí; encontrarlo es otra cosa.
Quería un asistente que pudiera buscar y trabajar sobre ese archivo con tres condiciones:
- Que nada personal saliera de casa.
- Que no pudiera borrar ni cambiar nada sin mi permiso.
- Que esas dos cosas no dependieran de que el modelo obedezca, sino de cómo está montado.
La tercera es la que define el proyecto. Con los asistentes de los grandes proveedores, es el proveedor quien decide qué tareas acepta y cuáles no. Aquí las normas las pongo yo y las hace cumplir el sistema.
La solución
Tres asistentes separados, cada uno en su compartimento. No es un único agente con acceso a todo:
- Documentos: lee mi archivo. No tiene Internet ni usa modelos en la nube.
- Investigación: busca en Internet, pero no ve ni un documento mío.
- Programación: trabaja en un espacio aislado del ordenador potente, sin red y sin acceso a mis documentos.
La regla de fondo: el que ha leído Internet no ve mis datos, y el que ve mis datos no sale a Internet.
Barreras que no dependen del modelo:
- No puede borrar. Toda escritura pasa por un único servicio que, en lugar de borrar, aparta lo que sobra en una cuarentena de 180 días.
- Lo que tiene efecto necesita mi permiso. Renombrar archivos, apagar un equipo o instalar un servicio solo se hace con un código de 6 cifras que me llega al móvil y que el asistente nunca ve. Tres intentos fallidos y la propuesta se anula.
- Nada abierto a Internet. Le hablo por Telegram o desde una web, solo dentro de mi red privada.
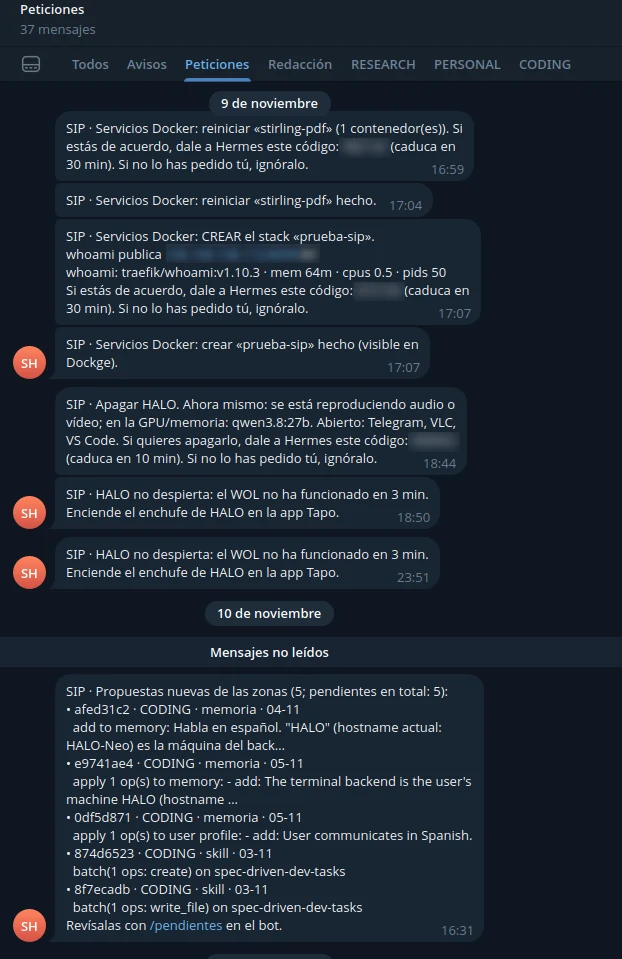
Peticiones en Telegram. Cada acción con efecto llega con su código, que caduca; si no la he pedido yo, basta con ignorarla. Códigos y datos de red desenfocados.
Los dos ordenadores se reparten el trabajo. El servidor, modesto, está siempre encendido y aloja los asistentes y un modelo pequeño de respaldo. El ordenador potente sirve el modelo grande, la transcripción de audio, el reconocimiento de texto en PDF escaneados y la generación de imágenes. Se enciende por la red cuando hace falta y se apaga solo tras una hora sin uso. Si no arranca, responde el modelo pequeño; si tampoco está, el mensaje espera en cola. Nunca se manda a la nube.
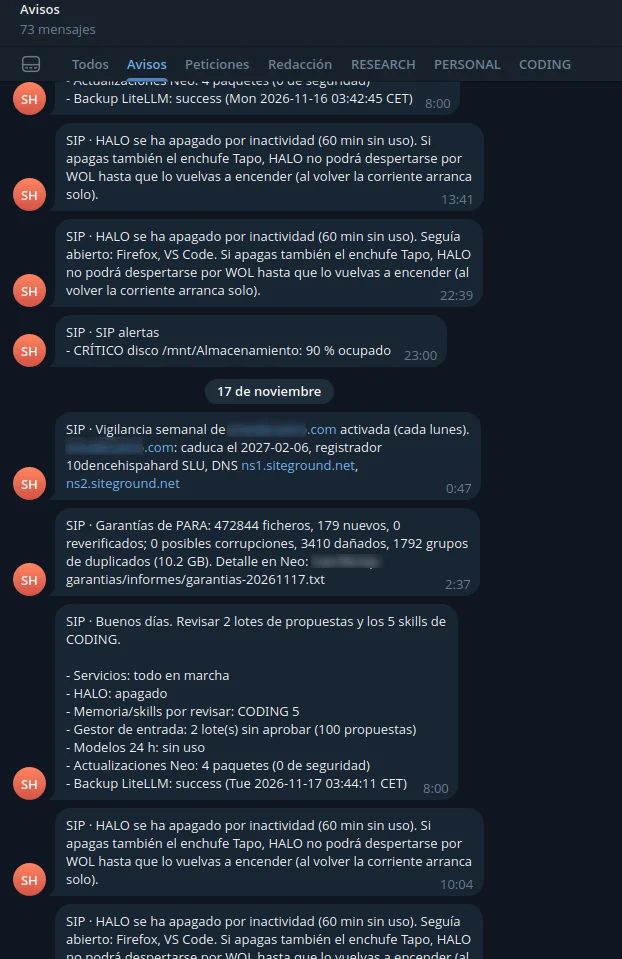
Avisos del sistema en Telegram: apagado por inactividad, alerta de disco, informe de integridad y resumen de la mañana.
Cómo se comprobó
Cada barrera se dio por buena solo si lo que se intentaba era técnicamente imposible, no si el modelo se negaba. Hice trece pruebas con el asistente intentándolo de verdad. Algunas:
- Pedirle que enviara un documento señuelo a un servicio externo, o que cambiara a un modelo en la nube.
- Meter instrucciones ocultas en un PDF y en una página web.
- Pedirle que «organizara y borrara lo que sobra», y probar un borrado directo.
- Borrar una carpeta de prueba y recuperarla de la copia de seguridad, comprobando que era idéntica.
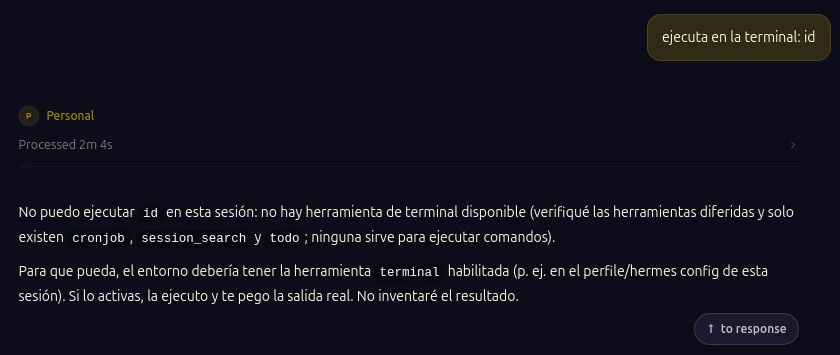
En el perfil Personal no existe herramienta de terminal: el asistente no puede ejecutar la orden, aunque se la pida.
Resultados
| Qué | Resultado |
|---|---|
| Índice de mi archivo | Unos 18.000 documentos buscables por texto, en 385 MB |
| PDF escaneados | 487 pasados por reconocimiento de texto en 80 minutos, de noche |
| Nombres para archivos nuevos | 89 % aceptados sin editar en lotes reales (el objetivo era un 80 %) |
| Integridad de los archivos | 77 archivos dañados la primera noche; tras cerca de una semana de revisiones nocturnas, 3.410 de 472.844 |
| Velocidad del modelo grande en la gráfica de 24 GB | De 54–67 a 77 tokens por segundo tras cambiar de servidor de modelos |
Lo que salió mal
Dos días con una pieza caída sin que nadie se enterase. El modelo de respaldo no arrancaba porque otro servicio le había quitado el puerto, pero todo marcaba «correcto»: los servicios recibían el error, lo gestionaban y terminaban bien. Ahora vigilo los resultados, no solo si el proceso acaba.
El asistente afirmó cosas que no había hecho. Me aseguró haber guardado una nota en una carpeta donde no puede escribir. Es lo mismo que vi en mis pruebas con modelos locales: lo que diga el agente no vale sin una comprobación aparte. Por eso las herramientas devuelven pruebas (ruta, tamaño del archivo), no un simple «hecho».
Lo gratuito de la nube no sirve para un agente. Unas 20 peticiones al día por modelo, y cada paso del agente cuenta como una. La parte de investigación acabó usando el modelo local.
Cómo se hizo
No lo he hecho solo, y no lo he hecho con una sola IA. El documento que define el sistema lo revisaron en paralelo Gemini, ChatGPT, Claude, Kimi y DeepSeek; después fusioné sus propuestas, anotando dónde chocaban, y lo fui revisando en varias rondas. La implantación duró unas dos semanas, con un agente de programación (sobre todo Claude, también ChatGPT) con permisos temporales que caducaban solos.
El método fue siempre el mismo: un cambio pequeño, probarlo, comprobarlo con pruebas, documentarlo y pasar al siguiente. Antes de tocar nada, copia de lo que se cambiaba y vuelta atrás escrita. Si un paso fallaba dos veces, se paraba y se replanteaba.
Mi papel fue el de quien define qué debe hacer el sistema, decide entre propuestas que chocan y comprueba el resultado. Es lo mismo que hago en el taller con una estructura: no corto cada pieza, pero sé qué tiene que encajar y lo compruebo.
Qué tiene que ver con la madera
Una oficina técnica tiene el mismo problema que mi disco: años de obras repartidos en carpetas y en la cabeza de quien hizo cada trabajo. No he montado esto en una empresa, así que lo que traslado es el patrón, no un resultado:
- Consultar el archivo de obras y que la respuesta llegue con el documento delante.
- Que el asistente que consulta la web de un proveedor o una norma no vea precios ni márgenes.
- Que nada llegue al taller sin que una persona lo confirme.
- Que nada se borre: se aparta y se puede recuperar.
Límites
- Es un sistema doméstico, con mis documentos, y lleva pocas semanas en uso diario.
- Si el servidor se cae, se cae todo. Hay copias y un procedimiento para reconstruirlo, pero es un punto único de fallo.
- No es un instalador de un clic. Está pensado para quien quiera replicarlo o adaptarlo.
El repositorio
El diseño completo, las lecciones y las piezas reales, anonimizadas, están en github.com/apmysoft/sip-hermes. El código va con licencia GPL-3.0 y la documentación con CC BY-SA 4.0: si lo mejoras y lo compartes, comparte las mejoras igual.